← blog / / 22 min
Jev de TypeSafe: qué es un System One Model y por qué importa
Qué es Jev de TypeSafe, cómo funciona un System One Model, qué lo diferencia de un LLM y cómo usarlo con TypeSafe y OpenRouter.
- + ia
- + modelos
- + agentes
Quizás estos días hayas visto mucho ruido alrededor de Jev. Todo el mundo está hablando de este nuevo (y revolucionario) modelo y enseñando proyectos chulísimos construidos en torno a él.
Pero… ¿qué narices es Jev y qué tiene de especial?
Jev es un modelo de IA bastante distinto a los LLM con los que nos hemos acostumbrado a trabajar.
No escribe artículos. No genera código. No mantiene una conversación. Ni siquiera intenta producir una respuesta en lenguaje natural.
Su trabajo es recibir un estado, responder a preguntas tipadas y devolver decisiones con probabilidades. Un clasificador, pero mucho más guay.
TypeSafe, la empresa que lo ha desarrollado, llama a esta categoría System One Models. Su propuesta es que no todas las tareas que hoy resolvemos con un LLM necesitan un modelo generativo capaz de escribir texto. Muchas aplicaciones solo necesitan tomar decisiones rápidas sobre información no estructurada. En el ecosistema actual de la IA, es frecuente que alguien ventile 100.000 tokens con GPT-6 e introduzca varios segundos de latencia para decidir entre A y B. Cada tool call en un sistema mal optimizado hace que muera un hada en el país de los programadores (y que se consuman varios litros de agua por la cara).
Algunos ejemplos:
- ¿Qué departamento debería gestionar este ticket?
- ¿El usuario está pidiendo un reembolso?
- ¿Qué nivel de severidad tiene esta incidencia?
- ¿Es segura esta acción de un agente?
- ¿Cuál de estas herramientas debería ejecutarse?
- ¿Este contenido necesita revisión humana?
Un LLM puede resolver perfectamente estos problemas. No siempre tiene sentido utilizar un modelo generativo generalista para hacerlo.
Jev intenta convertir ese tipo de juicio en una primitiva mucho más parecida a una función de software:
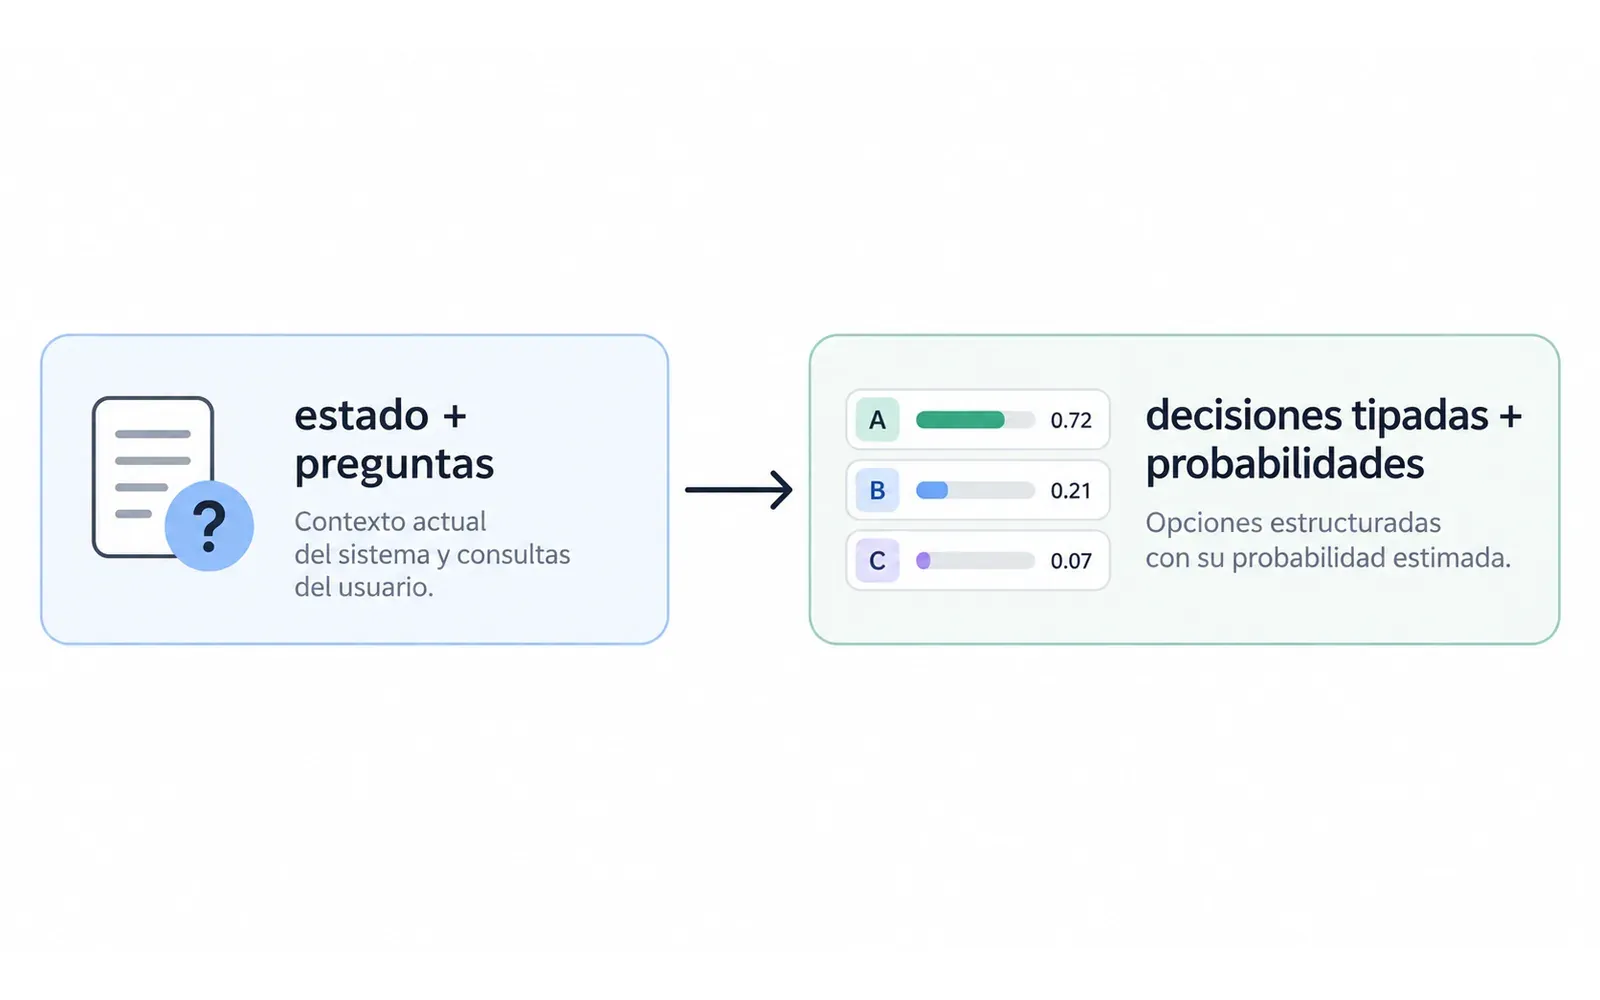
Según TypeSafe, esa especialización permite reducir drásticamente la latencia y el coste frente a los LLM en tareas que encajan con este patrón.
Esa es la parte más interesante de Jev.
No quiere competir por la frontera. No pretende hacer la landing más espectacular, con renders 3D y efectos de partículas. Ni one-shotear un minijuego en una tarde. No quiere sustituir a Claude, GPT o Gemini. Su planteamiento es que, quizás, solo quizás, estamos utilizando LLM para demasiadas cosas que no requieren generar lenguaje.
Este artículo está basado principalmente en la documentación y las publicaciones oficiales de TypeSafe AI. Jev acaba de publicarse, así que conviene distinguir entre características verificables del producto y benchmarks publicados por la propia compañía.
Índice
- ¿Qué es Jev?
- Un ejemplo sencillo
- ¿De dónde ha salido Jev?
- Jev no es un LLM de chat
- Jev frente a un LLM con Structured Outputs
- Jev frente a un clasificador tradicional como BERT
- Choice, Score y Noul
- Probabilidades calibradas
- Velocidad y coste
- Cómo utilizar Jev
- Casos de uso
- Por qué puede ser importante
- Lo que todavía no sabemos
- ¿Jev va a sustituir a los LLM?
- Preguntas frecuentes
¿Qué es Jev?
Jev es el primer modelo público de TypeSafe dentro de la familia que la compañía denomina System One Models.
La documentación oficial lo define como un modelo capaz de evaluar un state y responder a preguntas estructuradas devolviendo valores tipados y probabilidades.
La diferencia conceptual con un LLM puede resumirse así:
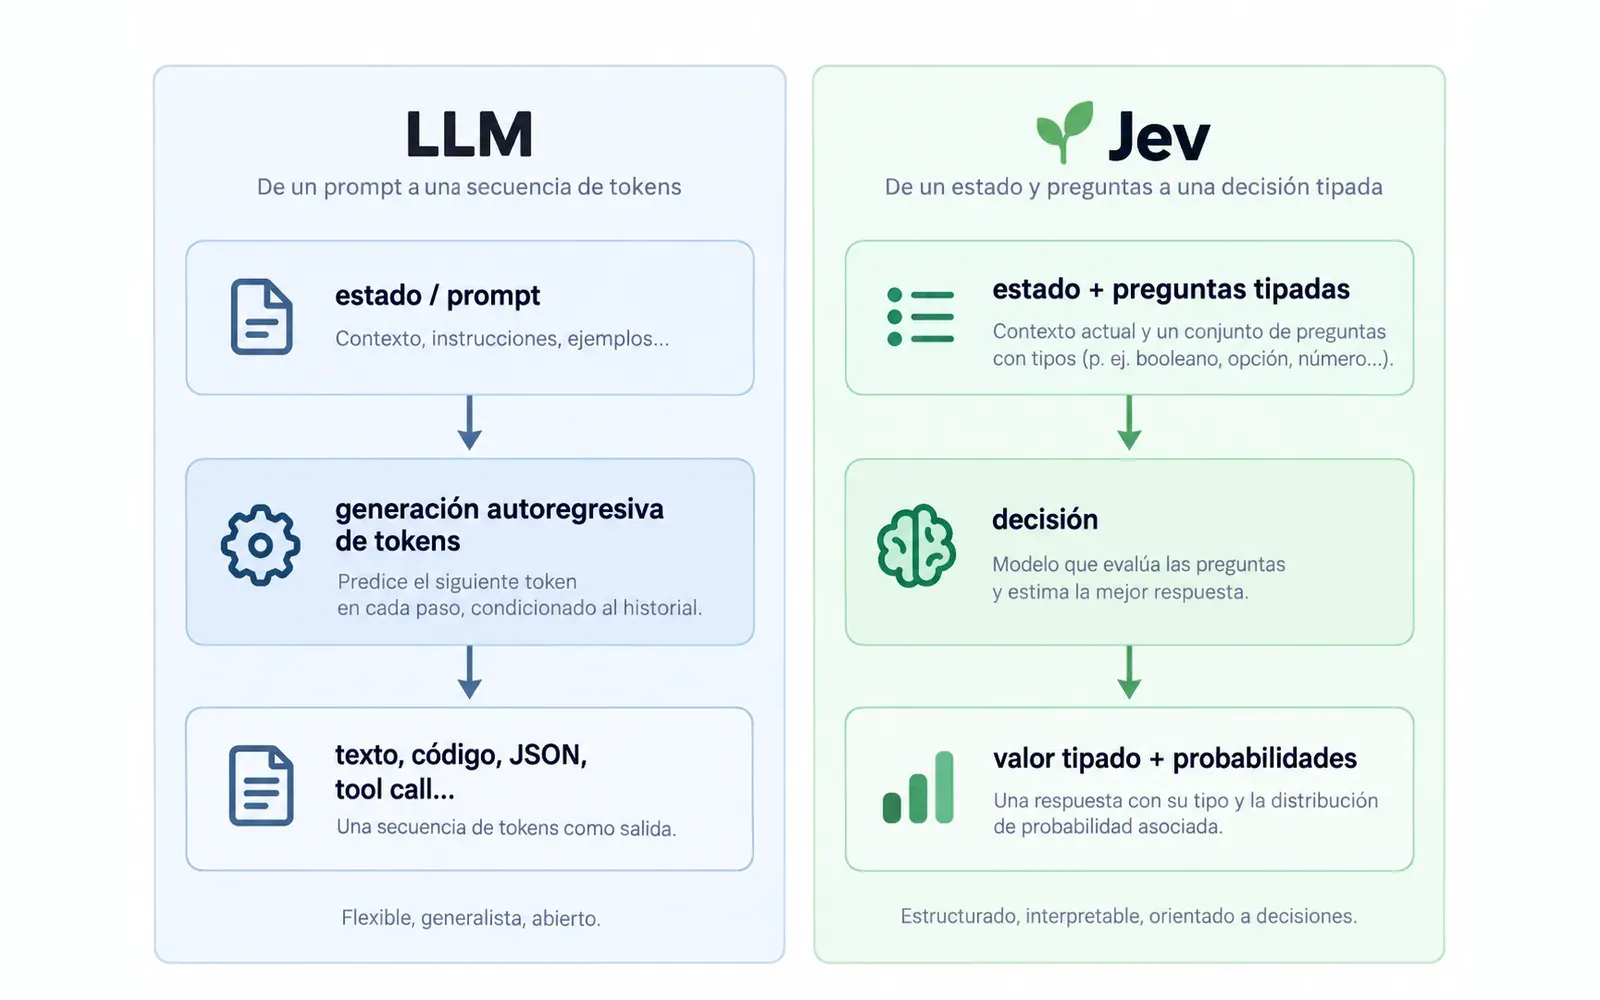
Un System One Model sigue entendiendo lenguaje natural. Puedes pasarle texto, objetos JSON o arrays con información textual. La salida es lo que cambia.
No genera una cadena arbitraria de texto. Eso, aunque a priori parezca una limitación, es su gran virtud.
Tú defines por adelantado qué pregunta quieres responder y qué forma puede tener la respuesta.
La documentación actual de TypeSafe ofrece tres primitivas:
Choice: elegir una opción entre varias.Score: valorar algo sobre una escala ordenada.Noul: estimar la probabilidad de que una afirmación sea cierta.
Esto permite utilizar el modelo como un bloque pequeño dentro de una aplicación convencional.
Un ejemplo sencillo
Imaginemos que recibimos este mensaje:
"Me habéis cobrado dos veces la suscripción. Necesito una solución rápido."De ahí podemos sacar cosillas.
Choice: elegir una categoría
{
  "type": "choice",
  "instructions": "¿Qué equipo debería gestionar este mensaje?",
  "criteria": {
    "billing": "Cobros, facturas y reembolsos",
    "technical": "Errores técnicos e integraciones",
    "sales": "Precios, contratación y ampliaciones"
  }
}
Jev puede devolver una respuesta equivalente a:
{
  "choice": "billing",
  "probabilities": {
    "billing": 0.97,
    "technical": 0.02,
    "sales": 0.01
  },
  "confidence": 0.96
}
Noul: responder a una pregunta binaria
{
  "type": "noul",
  "instructions": "¿El cliente expresa urgencia?"
}
La salida no es "yes", sino la probabilidad de que la respuesta sea sí:
0.94Score: situar algo en una escala
{
  "type": "score",
  "instructions": "¿Qué nivel de frustración expresa el cliente?",
  "criteria": [
    "Calmado",
    "Molesto",
    "Muy enfadado"
  ]
}
El resultado es una posición sobre esa escala y puede caer entre dos niveles.
Combinando las decisiones en código
Puedes hacer varias preguntas sobre el mismo estado y después componer sus respuestas con lógica determinista.
Siguiendo el ejemplo anterior de los casos de Noul y Choice:
if urgent > 0.90 and department == "billing":
    route_to_priority_billing()
else:
    normal_queue()
El modelo resuelve el juicio ambiguo, mientras que el código conserva el control del workflow.
¿De dónde ha salido Jev?
TypeSafe presentó públicamente Jev el 15 de septiembre de 2026.
Según la compañía, llevaba aproximadamente dos años desarrollándose en stealth (en secreto, vamos).
En el anuncio, TypeSafe describe Jev como el resultado de una pila construida específicamente para automatización, con:
- Una nueva arquitectura de modelo.
- Un sampler paralelo.
- Un método de entrenamiento llamado Reinforcement Learning for Calibrated Decisions (RLCD).
TypeSafe afirma que Jev alcanza niveles de inteligencia comparables a LLM existentes en tareas con forma de System One, pero con una latencia y un coste muy inferiores.
Es importante decir esa frase con todas y cada una de sus letras, porque he visto mucha confusión al respecto y, por supuesto, humo. No están diciendo que Jev tenga las capacidades generales de un modelo frontera.
No puede escribir, programar o mantener una conversación.
La comparación cobra sentido en los tipos de decisiones para los que ha sido diseñado.
El nombre System One está inspirado en la distinción entre pensamiento rápido y pensamiento deliberativo popularizada por Daniel Kahneman en Thinking, Fast and Slow, y el nombre Jev hace referencia al economista William Stanley Jevons.
TypeSafe conecta el nombre con la paradoja de Jevons: cuando aumenta muchísimo la eficiencia con la que utilizamos un recurso, pueden aparecer suficientes casos de uso nuevos como para que su consumo total termine aumentando. Pun intended. La intención de la compañía es ocupar aquellos nichos donde hoy es demasiado costoso (y lento) usar un LLM.
Jev no es un LLM de chat
Ya sabemos lo que es Jev. Ahora vamos a ver lo que NO es Jev.
Jev no está diseñado como sustituto general de ChatGPT, Claude o Gemini.
No genera strings.
No produce código.
No mantiene una conversación abierta.
TypeSafe incluso insiste en que System One no es un agente. El modelo no controla el workflow ni decide autónomamente cuál es su siguiente acción.
La arquitectura propuesta es justo la contraria:
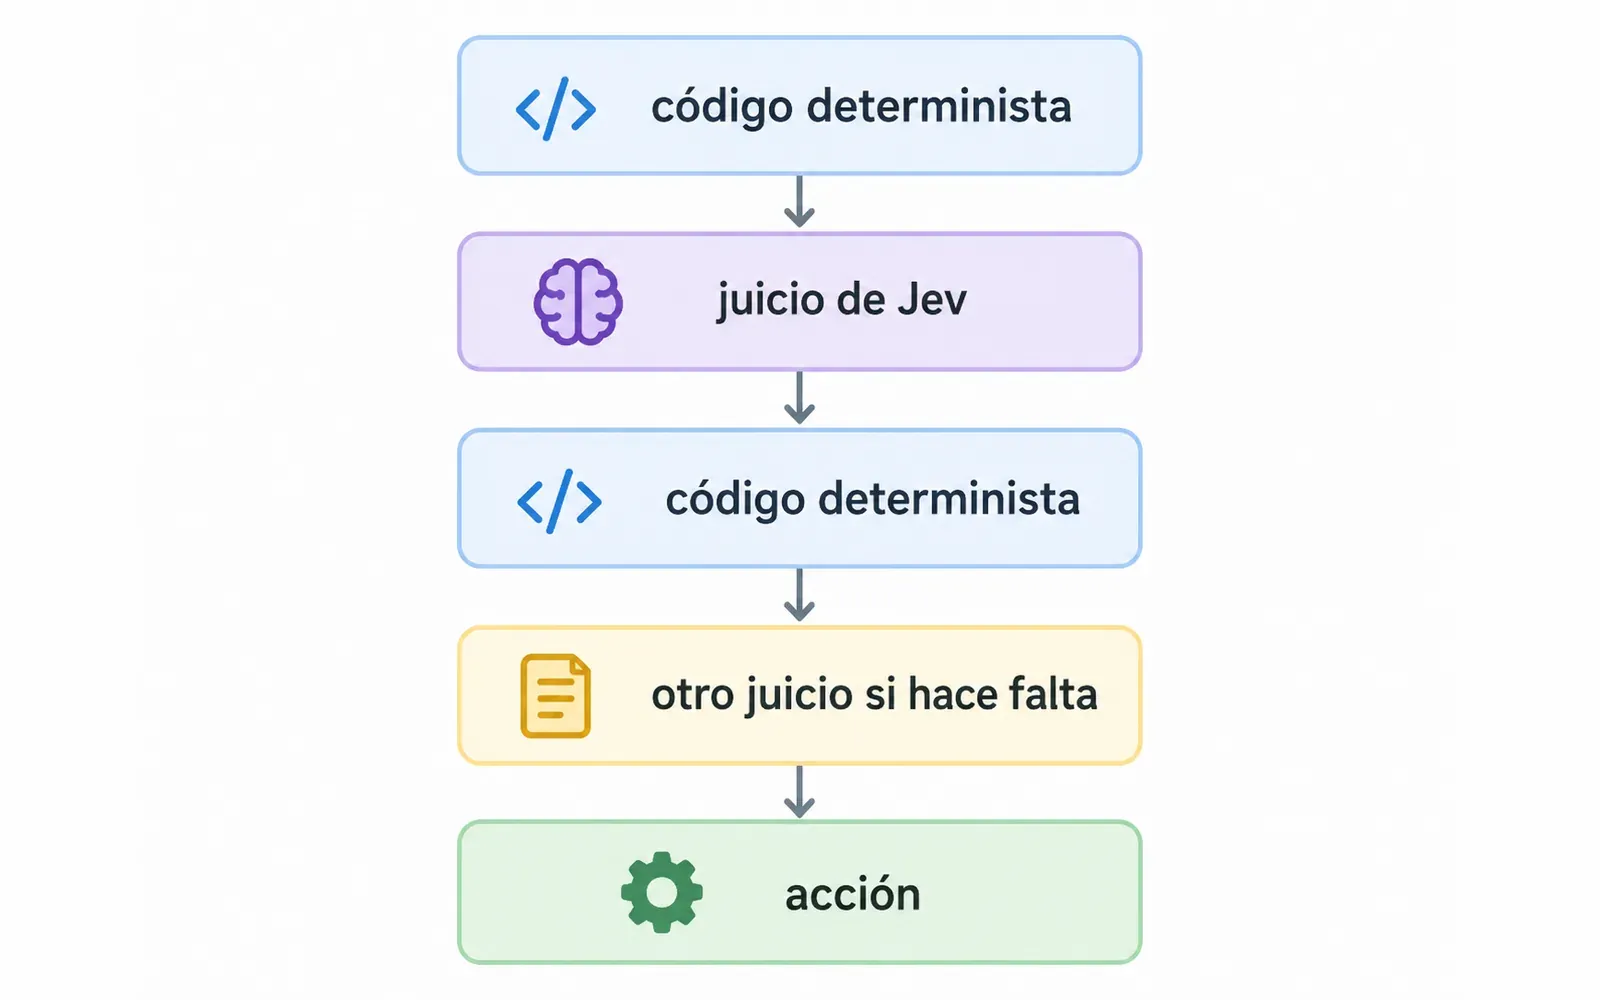
Por supuesto, eso no impide utilizar Jev dentro de un sistema agéntico. De hecho… lo pide a gritos.
Por ejemplo, un agente podría utilizar un LLM para planificar o programar y delegar en Jev decisiones frecuentes y acotadas como:
¿qué tool corresponde?
¿la tarea está terminada?
¿esta acción es arriesgada?
¿necesito pedir confirmación?
¿debo escalar a un modelo más caro?
En ese caso Jev sería una pieza del control plane, no el agente completo.
Jev frente a un LLM con Structured Outputs
Si eres perro viejo en esto de la IA y has llegado hasta aquí, seguramente estés pensando:
“Los LLM ya pueden devolver JSON y seguir un schema. ¿Qué tiene de nuevo esto?”
Es correcto.
Los structured outputs existen y los proveedores permiten obligar a modelos compatibles a generar respuestas que cumplan un JSON Schema.
Lo que pasa es que el valor de Jev no se reduce a devolver un JSON válido.
Un LLM generativo sigue utilizando generación autoregresiva: produce una secuencia token a token, aunque el resultado final esté restringido a un schema.
Jev está construido para devolver directamente decisiones tipadas y distribuciones de probabilidad. La diferencia está en la propia naturaleza de la inferencia.
Sus creadores afirman además que las preguntas independientes de una misma petición se evalúan en paralelo. Ojito.
Supongamos que sobre un ticket necesitamos saber:
categoría
urgencia
riesgo
frustración
si requiere humano
si solicita reembolso
si contiene información sensible
Con Jev podemos (y en teoría, debemos) enviar todas esas preguntas en una misma petición siempre que dependan del mismo estado.
El modelo las evalúa de forma independiente y paralela.
Añadir preguntas que quizá no termines necesitando apenas incrementa la latencia y después el código puede ignorar las respuestas irrelevantes. A esto se le llama speculative fan-out.
Es un patrón bastante diferente al de utilizar un chatbot como cerebro central del workflow.
Jev frente a un clasificador tradicional como BERT
La otra comparación natural es con los modelos de clasificación.
Después de todo, elegir una categoría entre varias no es algo nuevo.
Un clasificador tradicional puede ser extremadamente rápido y barato. Para un problema fijo y bien definido probablemente siga siendo una opción excelente.
Lo que pasa es que estos sistemas no son tan flexibles como la propuesta de Jev.
Un clasificador clásico suele entrenarse o ajustarse para una tarea y un conjunto concreto de etiquetas.
Jev pretende ser generalista.
Las opciones y sus criterios forman parte de la petición, por lo que pueden cambiar entre llamadas sin entrenar un modelo nuevo. Esto es un game changer en toda regla.
Hoy puedes preguntar:
billing | technical | salesy en otra llamada:
bug | feature_request | documentation | otherNo necesitas construir un nuevo classification head para cada taxonomía.
Tampoco significa que Jev haya inventado la clasificación zero-shot, que no se confunda el personal. Existen desde hace años formas de clasificar dinámicamente utilizando modelos NLI, embeddings o LLM.
La propuesta diferencial es la combinación de:
- Un modelo generalista.
- Decisiones tipadas como interfaz nativa.
- Probabilidades explícitas.
- Entrenamiento orientado a calibración.
- Preguntas paralelas.
- Un coste y latencia diseñados para insertar esas decisiones masivamente dentro de software.
Choice, Score y Noul: las tres primitivas
Choice
Choice selecciona una opción entre un conjunto definido.
Ejemplos:
¿En qué lenguaje está escrito este código?
¿Qué intención tiene este usuario?
¿Qué sentimiento expresa este texto?
Además de la opción elegida, Jev devuelve:
choice
probabilities
confidence
La API admite actualmente hasta 255 opciones en un Choice. Poquita broma.
Si el conjunto no cubre necesariamente todos los casos, se pueden incluir opciones como other o none_of_the_above.
Score
Score sirve para medir una posición sobre una escala ordenada.
Ejemplos:
¿Cuál es la severidad de este bug?
¿Cómo de frustrado está el usuario?
¿Qué calidad tiene este lead?
Los niveles se describen en lenguaje natural.
Por ejemplo:
0 -> impacto cosmético
1 -> funcionalidad degradada
2 -> bloquea una función importante
3 -> sistema inutilizable
El resultado puede caer entre niveles.
La API acepta actualmente hasta 10 niveles por Score.
Noul
Noul responde a una pregunta sí/no devolviendo directamente la probabilidad de que la respuesta sea afirmativa. Al final, todos los problemas se pueden resolver con booleanos… anidándolos mucho, ¿no?
Ejemplos:
¿Es peligrosa la acción del usuario?
¿Este texto contiene datos personales?
¿Esta acción debería requerir confirmación?
Una salida de:
0.93significa que el modelo asigna aproximadamente un 93 % de probabilidad al “sí”.
Noul no incluye un campo separado de confidence, porque la propia distancia respecto a 0.5 ya expresa la incertidumbre de la respuesta binaria.
¿Qué significa que Jev devuelve probabilidades “calibradas”?
El objetivo declarado de RLCD (Reinforcement Learning for Calibrated Decisions) es entrenar al modelo para que sus probabilidades reflejen mejor su incertidumbre, y la calibración se entiende sobre grupos de predicciones.
Si un modelo asigna alrededor de un 80 % de probabilidad a muchas decisiones comparables, un modelo bien calibrado debería acertar aproximadamente en ese entorno de frecuencia.
Pero cuidao, porque eso no convierte una predicción individual en una garantía.
Un 0.97 puede estar equivocado.
Tenemos que poder construir comportamiento alrededor de la incertidumbre:
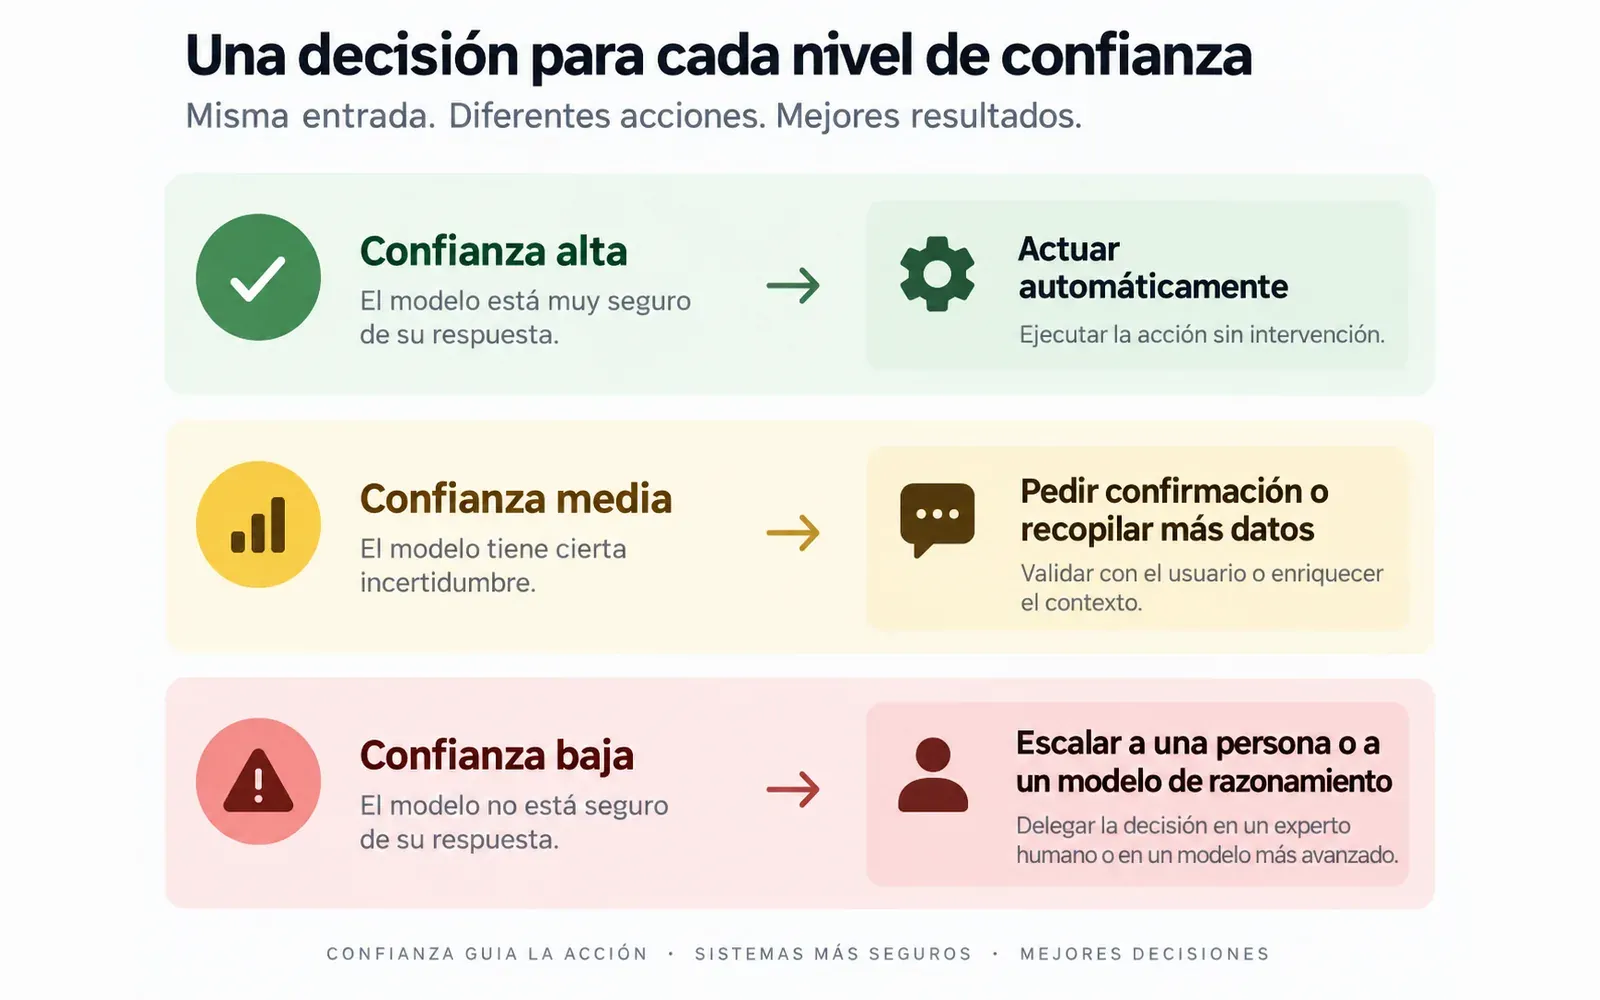
Los thresholds no son universales, es necesario evaluarlos con datos reales del dominio y ajustarlos según el coste de los errores.
No utilizaríamos el mismo umbral para elegir una pestaña de una interfaz que para aprobar una operación financiera.
”Jev no alucina”: qué significa realmente
TypeSafe utiliza expresiones como zero hallucinations, pero hay que interpretarlas correctamente. Ya sabes, marketing…
Jev puede equivocarse.
Puede clasificar mal.
Puede elegir la acción incorrecta.
Puede estar demasiado seguro de una respuesta.
Lo que no puede hacer es devolver un valor que esté fuera del espacio de salida que has definido.
Si un Choice solo permite:
billing
technical
sales
la salida no puede ser:
legalni texto arbitrario, ni una tool inventada, ni un objeto que no corresponda al tipo esperado. Es listo, pero imaginación… tiene poca.
TypeSafe explica que su cifra de cero errores de schema no procede de un benchmark, sino que el schema matching está garantizado por construcción.
Eso es útil para automatización, pero no debe confundirse con una garantía de corrección semántica. Una aplicación seria sigue necesitando evaluar precisión, calibración y comportamiento sobre su propia distribución de datos.
Velocidad y coste
Esta es la parte que más llama la atención.
En el momento de escribir este artículo, TypeSafe publica para Jev 1.13 un precio de $0.042 por millón de tokens de entrada y $0 por tokens de salida. Llama la atención, desde luego.
Según la documentación, la mayoría de las consultas se completan en torno a 100 ms, aunque el anuncio de lanzamiento sitúa el rango observado aproximadamente entre 70 y 500 ms.
La compañía publica benchmarks de workflows System One donde obtiene mejoras mucho mayores frente a LLM, incluyendo cifras de hasta:
193,6x más rápido
444,6x más baratoFlipas.
Pero aquí conviene poner un asterisco grande. Muy grande.
Son benchmarks publicados por TypeSafe sobre workflows diseñados alrededor del paradigma que Jev pretende resolver.
La propia empresa reconoce en su publicación de lanzamiento que esas cifras están probablemente en la parte alta de las ganancias que espera ver en casos reales y que algunos de los workflows fueron construidos por miembros de su propio equipo, lo que puede introducir sesgo.
Jev no es 444 veces mejor que Claude. En ciertas tareas estructuradas de decisión, un modelo especializado puede ser muchísimo más eficiente que utilizar un LLM generativo.
Que en sí ya es algo que mola bastante, no hace falta adornarlo.
Contexto, límites y estado actual
A fecha de redacción de este artículo, Jev está en su versión 1.13.0.
En la API directa de TypeSafe, tenemos:
- Hasta 64K tokens en el presupuesto total de la petición.
- Límite de 32K para
state + pregunta más larga. - Entrada exclusivamente textual.
- Strings, objetos JSON o arrays con valores de texto.
- Sin imágenes, audio o vídeo de forma nativa (Hay ganitas de ver este bicho siendo multimodal).
Desde TypeSafe indican que el idioma principal de entrenamiento de Jev es inglés, aunque yo lo he estado probando en español y los resultados me han convencido, pese a que advierten de que puede perder precisión.
Cómo utilizar Jev
Opción 1: API directa de TypeSafe
TypeSafe expone Jev mediante:
POST https://api.typesafe.ai/v1/systemoneNecesitas una API key y una petición con tres elementos principales:
model
state
questions
Un ejemplo mínimo con curl sería:
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {
      "message": "Me habéis cobrado dos veces y necesito una solución hoy."
    },
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this message?",
        "criteria": {
          "billing": "Billing, charges and refunds",
          "technical": "Bugs and technical problems",
          "sales": "Pricing and sales enquiries"
        }
      },
      "urgent": {
        "type": "noul",
        "instructions": "Does this message communicate urgency?"
      }
    }
  }'
También ofrecen SDK oficiales para Python y JavaScript/TypeScript.
Recomiendan utilizar el alias jev-latest para pruebas y fijar una versión concreta cuando necesites estabilidad de comportamiento en producción.
Opción 2: usar Jev desde OpenRouter
Jev también está disponible oficialmente a través de OpenRouter.
Actualmente aparecen:
typesafe/jev-1.13y el alias:
~typesafe/jev-latestOpenRouter publica para Jev 1.13 el mismo precio base:
$0.042 / millón de tokens de entrada
$0 / millón de tokens de salida
La integración es un poco diferente a utilizar un modelo de chat.
Jev aparece en OpenRouter como un modelo de tipo Decisions, y OpenRouter está mostrando esta integración dentro de sus funciones experimentales de Labs.
En el SDK oficial de TypeScript, sus propios ejemplos utilizan:
import { OpenRouter } from "@openrouter/sdk";

const openRouter = new OpenRouter({
  apiKey: process.env.OPENROUTER_API_KEY!,
});

const { answers } = await openRouter.alpha.decisions.create({
  decisionsRequest: {
    model: "typesafe/jev-1.13",
    state: {
      message: "The customer says they were charged twice."
    },
    questions: {
      department: {
        type: "choice",
        instructions: "Which team should handle this?",
        criteria: {
          billing: "Charges, invoices and refunds",
          technical: "Technical problems",
          sales: "Sales enquiries"
        }
      },
      duplicateCharge: {
        type: "noul",
        instructions: "Does the customer report a duplicate charge?"
      }
    }
  }
});

console.log(answers);
Como la API de decisiones aparece actualmente bajo alpha, conviene comprobar la documentación de OpenRouter antes de construir una dependencia rígida sobre esta interfaz.
La ventaja de OpenRouter es evidente si ya centralizas allí el acceso a modelos, ya que puedes probar Jev sin introducir inmediatamente otro proveedor y comparar su comportamiento con otros modelos dentro de la misma infraestructura. Y que no te tienes que apuntar a la waitlist, aunque la espera sea realmente corta.
Casos de uso interesantes para Jev
Hazte la siguiente pregunta:
“¿Dónde estoy utilizando un modelo generalista únicamente para tomar una decisión acotada?”
Ahí empiezan a aparecer casos interesantes.
1. Routing de herramientas en agentes
Un agente dispone de un conjunto conocido de tools.
En muchos sistemas utilizamos un LLM para seleccionar cuál ejecutar:
search_web
read_file
run_tests
query_database
ask_user
finish
Si el trabajo en ese punto consiste realmente en escoger entre acciones conocidas, Choice encaja de forma natural.
Podríamos incluso preguntar en paralelo:
next_tool
needs_user_input
task_finished
risk_level
requires_confirmation
y dejar que el código construya el siguiente paso.
Puede reducir la cantidad de veces que necesitas invocarlo para pequeñas decisiones de control.
Pero no uses Jev como router de modelos o te acabarás reventando el cache hit.
2. Triaje de soporte
Es probablemente el ejemplo más evidente:
departamento
prioridad
tipo de solicitud
frustración
riesgo de churn
necesita humano
solicita reembolso
Todas esas señales pueden evaluarse sobre el mismo state en una sola petición.
Después, reglas deterministas pueden decidir el routing y las acciones.
3. Lead scoring y clasificación comercial
En un CRM podrías convertir información no estructurada sobre una empresa o conversación en señales como:
ICP match
intención de compra
urgencia
tipo de necesidad
calidad del lead
requiere seguimiento
Jev nos permite utilizarlo como capa de interpretación antes de aplicar reglas de negocio.
4. Guardrails para agentes y LLM
OpenRouter muestra precisamente una demo de agent action approval donde varias propiedades de una tool call se evalúan en paralelo.
Un patrón podría ser el siguiente:
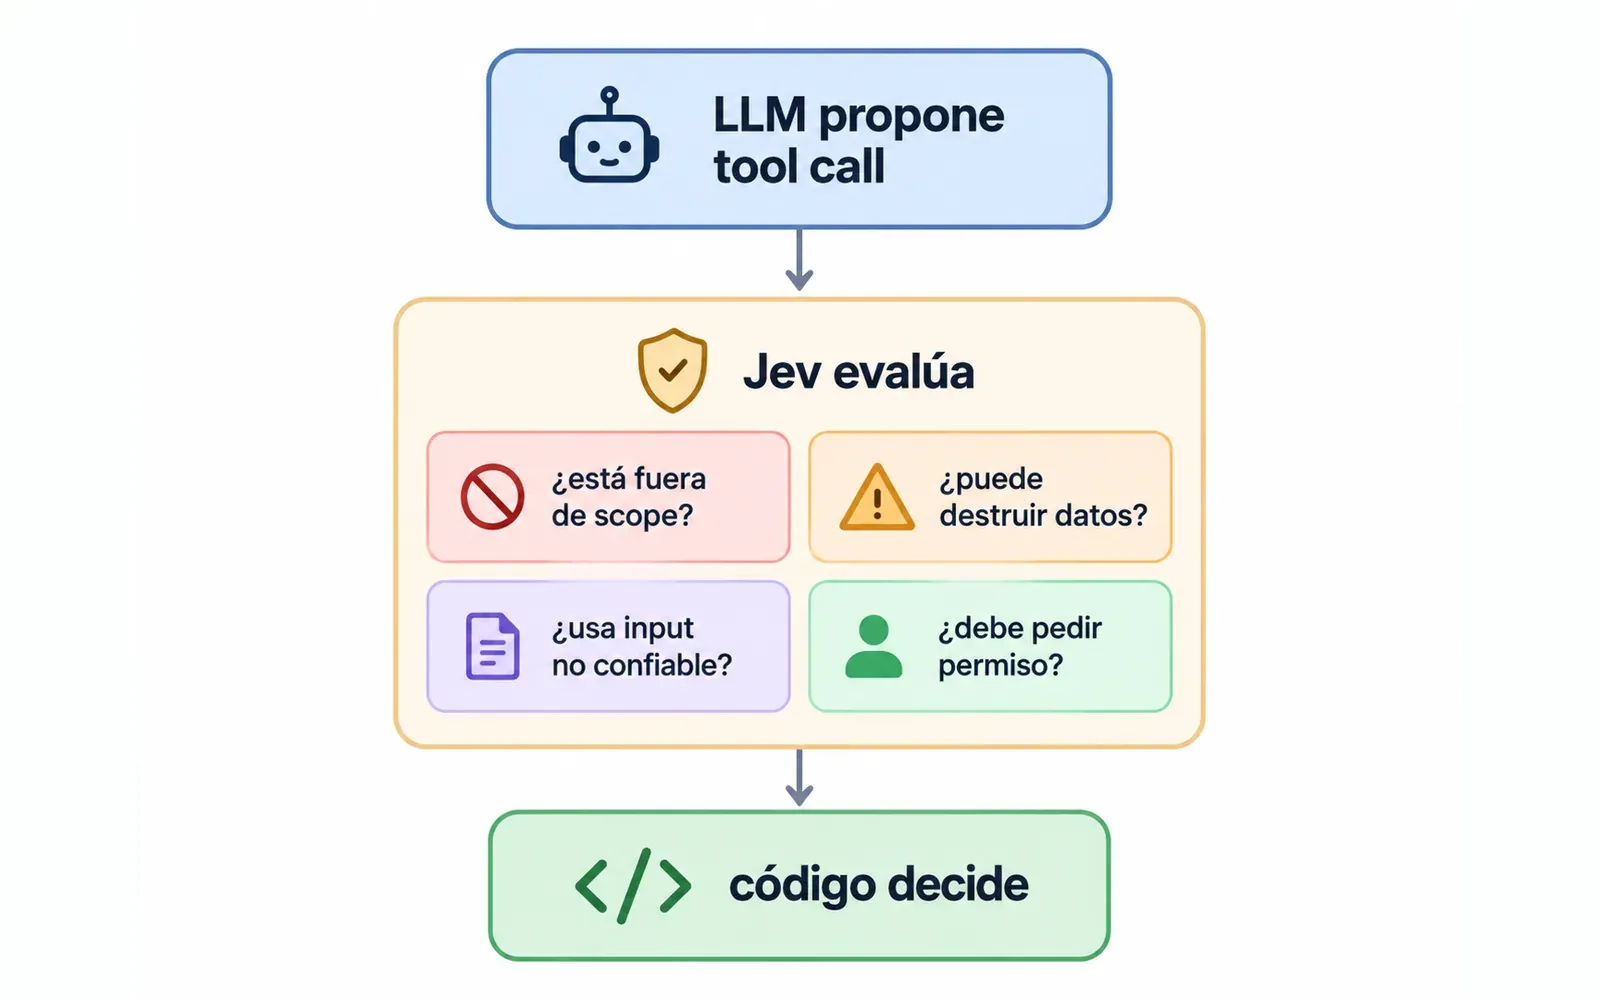
Es especialmente interesante cuando esas verificaciones deben ejecutarse muchas veces durante un bucle agéntico.
5. Moderación y filtrado
Un sistema podría evaluar muchas señales simultáneamente:
spam
acoso
contenido promocional
información personal
rage bait
necesita revisión
6. Clasificación masiva de documentos o registros
TypeSafe plantea System One también para trabajar sobre grandes volúmenes de datos.
Cuando necesitas convertir texto en features o etiquetas estructuradas a escala, el coste de cada inferencia empieza a importar muchísimo.
Algunos ejemplos:
emails
tickets
reseñas
logs
artículos
transcripciones
incidencias
registros CRM
7. Interfaces en tiempo real
Si una decisión tarda alrededor de 100 ms en vez de varios segundos, se vuelve posible introducir IA en paths interactivos donde un LLM generativo puede sentirse lento.
Por ejemplo:
adaptar una interfaz
priorizar acciones
interpretar comandos
seleccionar una respuesta predefinida
clasificar eventos en tiempo real
Jev sigue siendo actualmente text-only, por lo que un sistema de computer use visual necesitaría primero transformar el estado visual en una representación textual o estructurada mediante otro componente. Pero ya hay por ahí implementaciones chulas de computer y browser use, e incluso generación de UI en tiempo real.
Por qué algo como Jev puede ser importante
Durante los últimos años los LLM se han convertido en una especie de primitive universal.
Necesitas generar texto: LLM.
Necesitas programar: LLM.
Necesitas resumir: LLM.
Necesitas decidir entre tres categorías: LLM.
Necesitas devolver un booleano: también LLM.
Tiene sentido. Los modelos generativos son extremadamente flexibles y cada vez mejores.
Lo malo es que esa flexibilidad también significa que estamos utilizando una maquinaria diseñada para generar secuencias arbitrarias de lenguaje incluso cuando el resultado que necesita nuestro software es… un booleano, una probabilidad acotada o un elemento de un array de tres. Lo ves ya, ¿no?
Jev plantea otra primitiva:
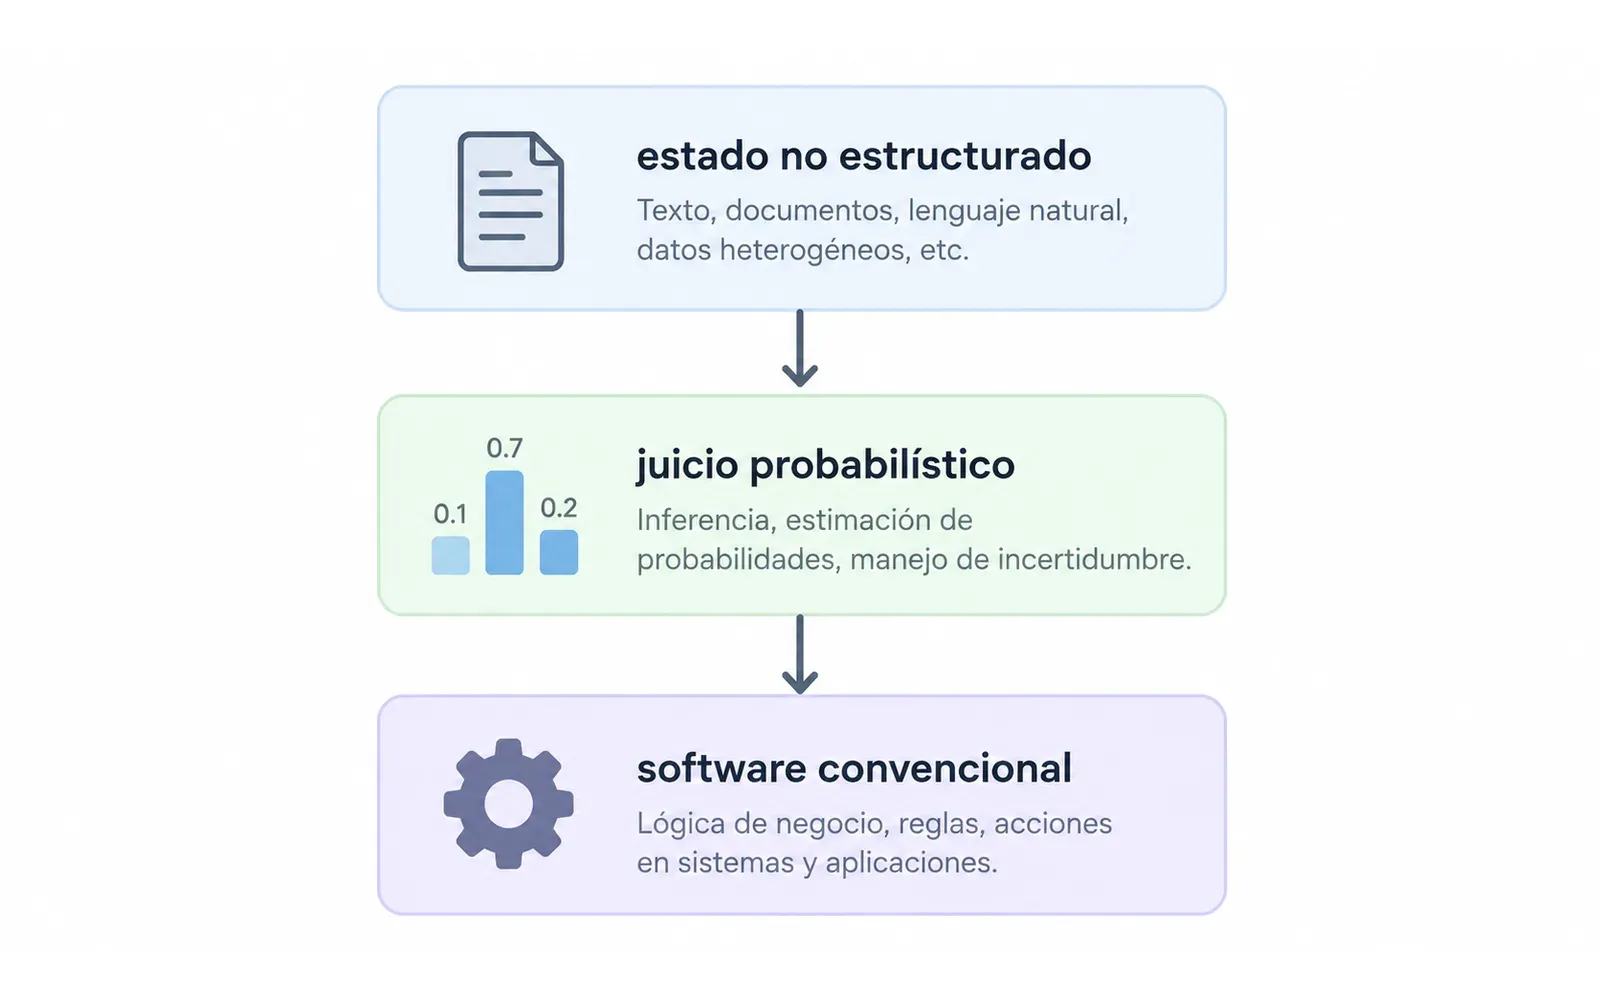
Eso podría ser relevante por tres motivos.
1. Separa inteligencia y control
En lugar de meter toda la lógica en un prompt gigante puedes mantener el workflow en código y utilizar el modelo solo para las partes que realmente requieren juicio.
Eso hace que cambiar una regla no implique necesariamente cambiar el comportamiento cognitivo completo del sistema.
2. Convierte la incertidumbre en parte de la API
La salida no es únicamente:
Asino:
A: 0.74
B: 0.22
C: 0.04
El software puede reaccionar de forma diferente según esa incertidumbre.
Es una interfaz mucho más natural para automatización que fingir que todas las decisiones del modelo son igualmente seguras.
3. El precio puede cambiar dónde merece la pena usar IA
Cuando una inferencia es cara y lenta, solo compensa utilizarla en decisiones importantes (y que tengan cierto margen para ser leeeeentas).
Cuando una inferencia cuesta una cantidad casi despreciable y responde en torno a cientos de milisegundos, empiezan a aparecer usos para decisiones muchísimo más pequeñas.
Y volvemos a Jevons.
Si el coste de introducir “sentido común programable” dentro de una aplicación cae uno o dos órdenes de magnitud, quizá no utilizaremos menos inteligencia artificial, puede que empecemos a meterla hasta en la sopa.
Lo que todavía no sabemos
Jev es extremadamente reciente.
Eso obliga a separar una propuesta interesante de una conclusión prematura.
Los benchmarks proceden principalmente de TypeSafe
TypeSafe ha publicado bastante información sobre sus evaluaciones y, de hecho, incluye varios caveats sobre ellas.
Peeeeeero siguen siendo benchmarks del fabricante.
Necesitamos tiempo para ver evaluaciones independientes, cargas reales y comportamiento sostenido en producción.
No conocemos todos los detalles de la arquitectura
TypeSafe habla de una nueva arquitectura, un sampler paralelo y RLCD.
Eso no significa que exista una especificación pública suficiente para reproducir Jev fielmente.
Que aparezca un proyecto abierto con una API similar no implica automáticamente que haya reconstruido el modelo de TypeSafe. Es muy posible que se estén intentando subir al tren del hype.
La calibración debe evaluarse en cada dominio
Una probabilidad útil en un benchmark general puede no estar igualmente calibrada sobre tus datos.
Antes de convertir:
0.90 -> ejecutar automáticamenteen una regla de producción, hay que medir qué significa realmente ese 0.90 sobre tu distribución.
Jev solo acepta texto actualmente
Nada de visión, audio o vídeo de forma nativa. Lástima…
Puedes preprocesar esos datos con otros sistemas, pero entonces las propiedades y los errores del pipeline completo cambian.
Su idioma principal es el inglés
TypeSafe acepta otros idiomas, pero avisa explícitamente de que la precisión puede ser menor.
Para productos en español es una limitación que merece pruebas específicas. De momento yo te digo que sabe perfectamente que decirle a alguien “Tienes menos luces que un barco pirata” lo interpreta como insulto con mucha confianza. Lo he probado.
Un juicio rápido no sustituye al razonamiento cuando el problema requiere razonamiento
La propia documentación de TypeSafe recomienda preguntas atómicas que una persona informada podría juzgar rápidamente.
Si preguntas:
“Analiza toda esta situación empresarial y dime cuál es la mejor estrategia para los próximos cinco años.”
estás utilizando la herramienta equivocada.
System One funciona mejor cuando puedes descomponer el problema en pequeños juicios y componer sus resultados en código.
Entonces, ¿Jev va a sustituir a los LLM?
Si a estas alturas del artículo esa es tu pregunta, no te estás enterando de la película.
Jev elimina deliberadamente capacidades que hacen poderosos a los LLM.
No puede escribir.
No puede programar.
No puede mantener una conversación general.
No puede desarrollar un razonamiento textual largo.
A cambio, intenta ser muchísimo más eficiente en un espacio mucho más estrecho.
Una arquitectura razonable podría terminar teniendo las dos cosas:
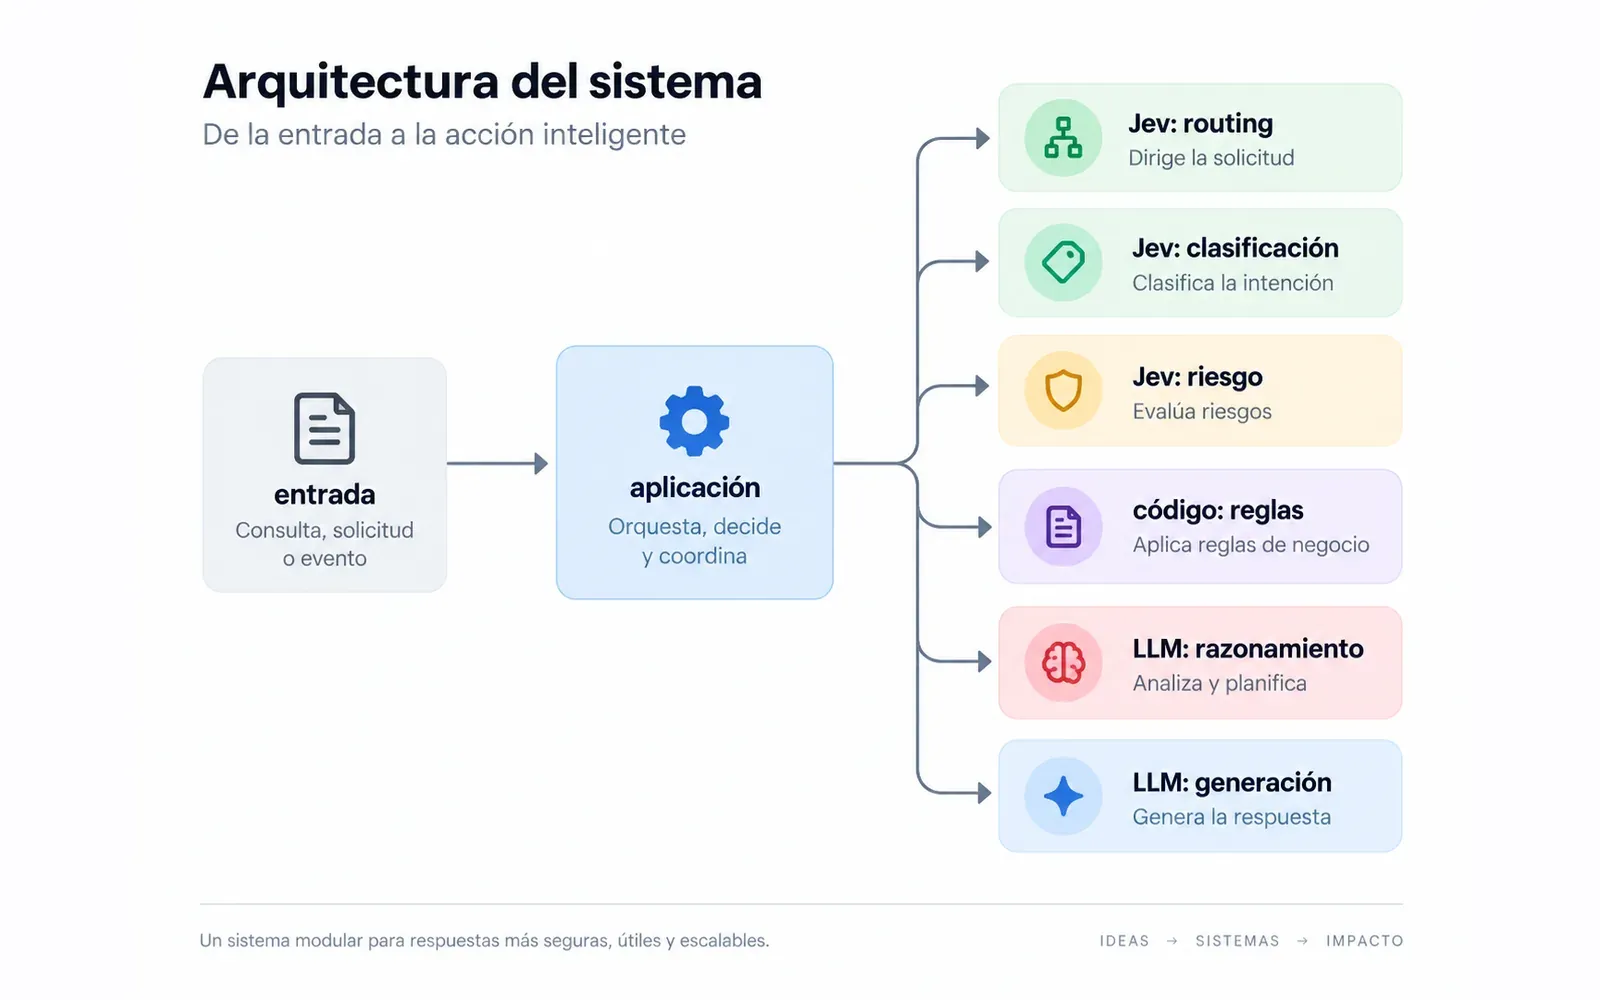
El modelo generativo sigue siendo fundamental cuando necesitas producir algo nuevo o resolver un problema abierto.
Jev intenta cubrir los momentos en los que solo necesitas tomar una decisión.
Si el enfoque funciona bien fuera de las demos, esa especialización puede acabar siendo más relevante de lo que parece.
Jev tiene el potencial para demostrar que una parte considerable del software inteligente del futuro no necesita generar lenguaje para ser inteligente.
Preguntas frecuentes sobre Jev
¿Qué es Jev de TypeSafe?
Jev es el primer System One Model público de TypeSafe AI. Recibe un estado textual y preguntas tipadas y devuelve decisiones estructuradas con probabilidades en lugar de generar texto libre.
¿Jev es un LLM?
TypeSafe lo presenta como una clase diferente de modelo. Jev no genera strings de forma autoregresiva como un LLM de chat y está especializado en decisiones estructuradas.
¿Jev puede generar texto o código?
No. Su interfaz está orientada a decisiones tipadas mediante Choice, Score y Noul.
¿Qué es un System One Model?
Es el nombre que TypeSafe utiliza para modelos optimizados para realizar juicios rápidos y estructurados dentro de software. El término está inspirado en el concepto de pensamiento rápido o System 1 popularizado por Daniel Kahneman.
¿Qué es RLCD?
RLCD significa Reinforcement Learning for Calibrated Decisions. Es el método de entrenamiento que TypeSafe dice haber desarrollado para optimizar System One Models alrededor de decisiones probabilísticas calibradas.
¿Qué tipos de salida tiene Jev?
Actualmente existen tres primitivas principales:
Choice: selecciona una opción y devuelve su distribución de probabilidades.Score: sitúa una respuesta sobre una escala ordenada.Noul: devuelve la probabilidad de que una afirmación sea cierta.
¿Jev puede equivocarse?
Sí. La salida siempre respeta el tipo y el conjunto de valores permitido, pero la decisión puede ser incorrecta. Type safety no equivale a exactitud.
¿Cuánto cuesta Jev?
En el momento de escribir este artículo, TypeSafe y OpenRouter publican un precio de 0,042 dólares por millón de tokens de entrada para Jev 1.13 y no cobran los tokens de salida.
¿Se puede usar Jev con OpenRouter?
Sí. OpenRouter ofrece Jev 1.13 como typesafe/jev-1.13 y un alias hacia la versión más reciente. La API específica de decisiones aparece actualmente como una funcionalidad experimental.
¿Jev acepta imágenes?
No directamente. La documentación actual de TypeSafe indica que Jev acepta únicamente texto, incluyendo strings y estructuras JSON con contenido textual.
¿Jev sirve para agentes?
Puede utilizarse dentro de un sistema agéntico para decisiones como routing, aprobación de acciones o evaluación de riesgo. TypeSafe, sin embargo, no presenta System One como un agente: el control flow debe seguir estando en código.
Fuentes oficiales
La información técnica y las cifras de este artículo se han contrastado principalmente con documentación primaria y fuentes oficiales: